

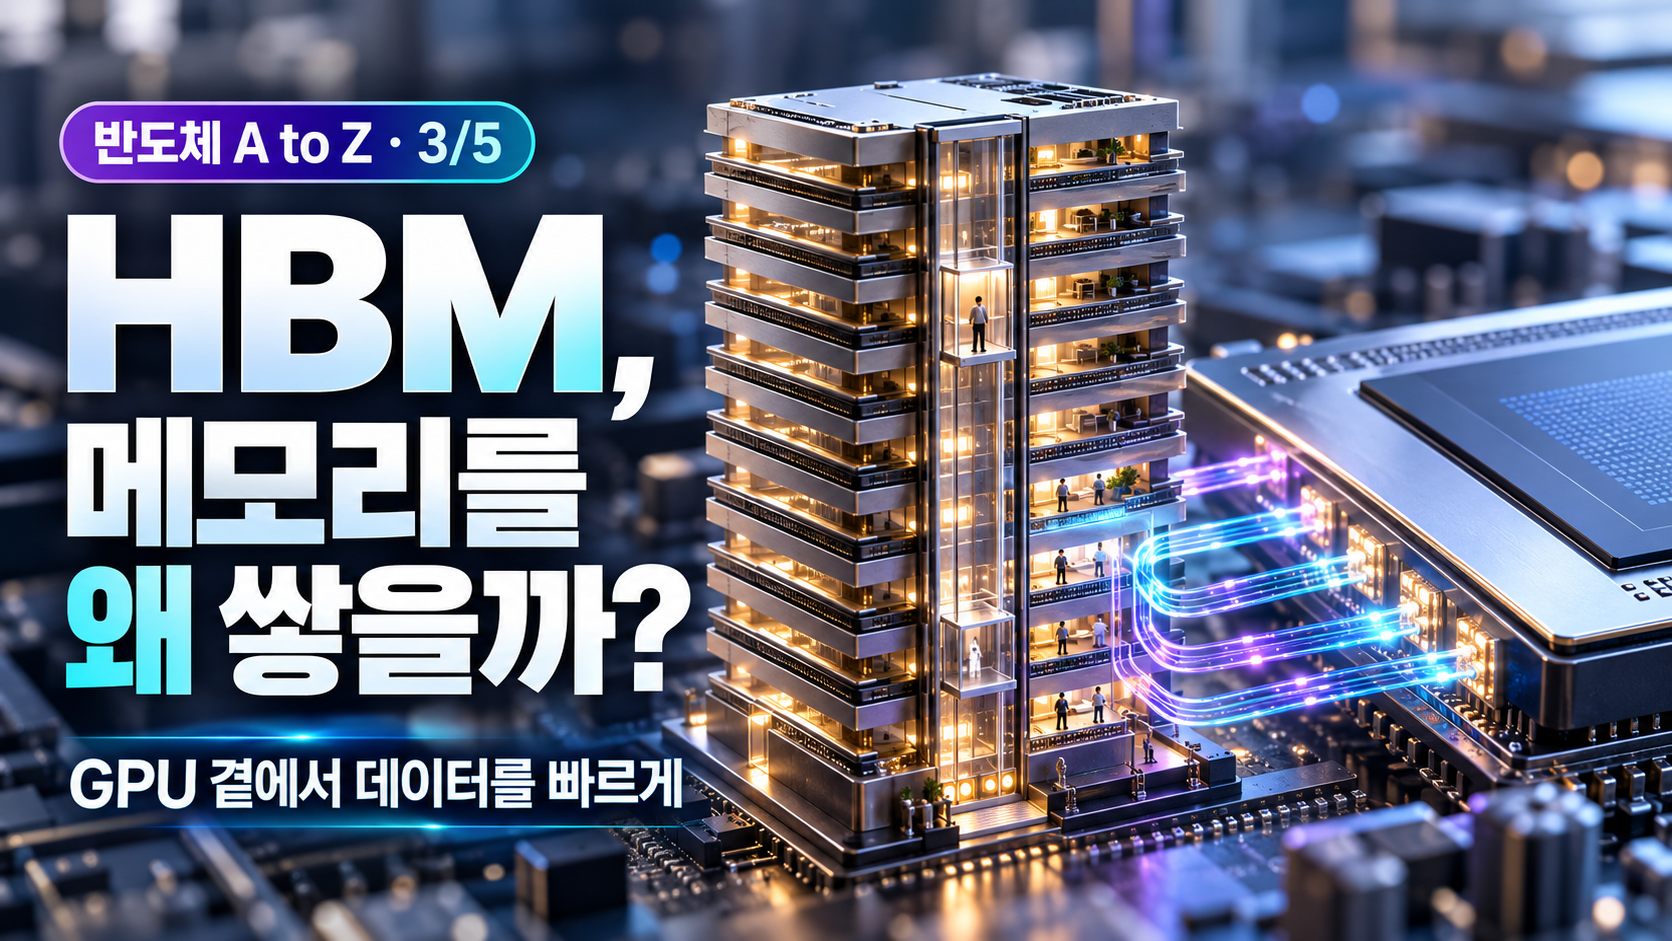
HBM4란? D램을 아파트처럼 쌓는 이유와 SK하이닉스·삼성·키옥시아 지도
HBM4는 D램 칩을 12~16층으로 쌓아 GPU 바로 옆에 붙이는 6세대 고대역폭 메모리입니다. 이 글은 메모리가 칩 안에서 맡는 역할부터 D램과 낸드의 차이, 쌓는 기술(TSV), HBM4가 이전 세대와 무엇이 다른지, 그리고 SK하이닉스·삼성전자·마이크론·키옥시아가 어디에 서 있는지까지 정리합니다.
1편 공정 순서 · 2편 미세공정 · 3편 HBM4·메모리(지금) · 4편 패키징·기판 · 5편 데이터센터 랙
메모리는 무엇을 하나: 요리사·조리대·창고
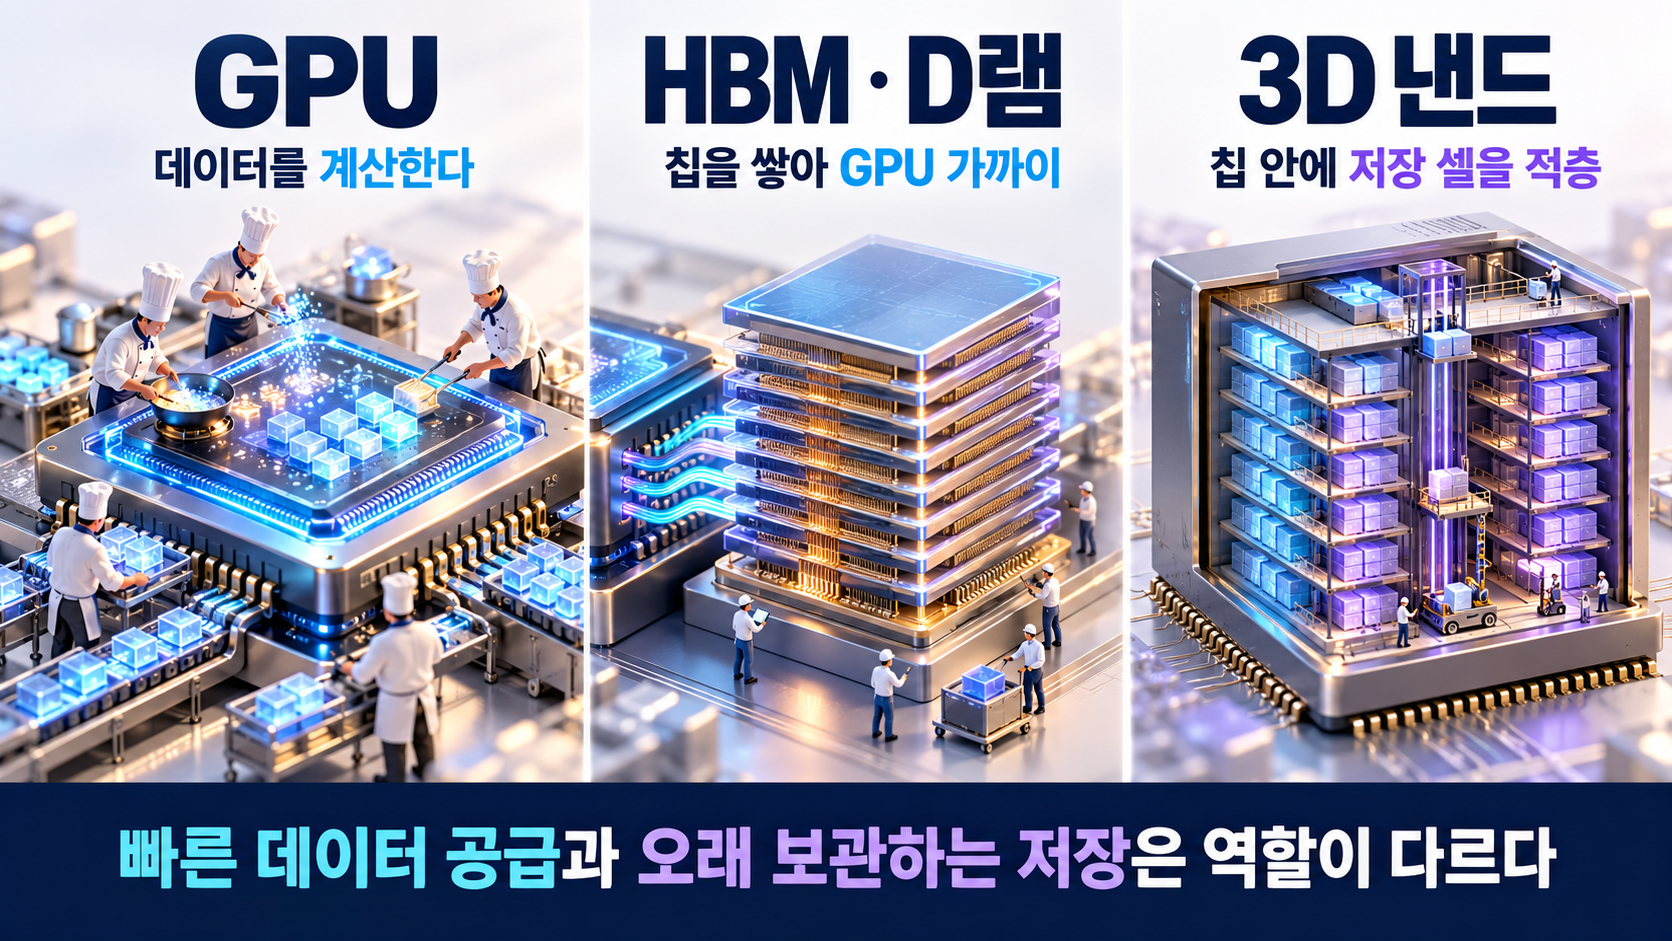
1·2편에서 본 GPU와 CPU는 계산을 하는 로직 반도체입니다. 반면 메모리 반도체는 데이터를 담아 두는 곳입니다. 주방에 비유하면 GPU는 요리사, D램은 요리사 바로 앞의 조리대, 낸드플래시는 식재료를 보관하는 창고입니다.
| 종류 | 비유 | 특징 | 주로 쓰이는 곳 | 주요 회사 |
|---|---|---|---|---|
| D램 | 조리대 | 빠르지만 전원이 꺼지면 내용이 사라짐(휘발성) | PC·서버 메인 메모리, HBM | 삼성전자·SK하이닉스·마이크론·CXMT |
| HBM | 요리사 옆에 쌓은 다층 조리대 | D램을 여러 층 쌓아 한꺼번에 많은 데이터를 주고받음 | AI GPU 전용 | SK하이닉스·삼성전자·마이크론 |
| 낸드플래시 | 창고 | 느리지만 전원이 꺼져도 보존(비휘발성) | SSD, 스마트폰 저장공간 | 삼성전자·SK하이닉스·키옥시아·샌디스크·마이크론 |
회사는 대표 예시
요리사가 아무리 빨라도 조리대가 좁거나 재료가 늦게 오면 요리가 늦어집니다. AI 계산이 바로 이 상황입니다. GPU의 계산 속도는 빠르게 늘었지만, 메모리에서 데이터를 가져오는 속도가 따라가지 못하는 현상을 ‘메모리 벽’이라고 부릅니다. 거대한 AI 모델은 수천억 개의 숫자(매개변수)를 계속 읽어야 하므로, 메모리 속도가 곧 AI 속도가 됩니다.
로직(GPU)은 계산, 메모리는 보관. AI에서는 ‘얼마나 빨리 계산하나’만큼 ‘얼마나 빨리 데이터를 공급하나’가 중요해졌고, 그 해답이 HBM이다.
HBM은 왜 쌓을까: TSV와 넓은 고속도로
일반 D램은 메인보드 위 슬롯에 꽂혀 CPU와 비교적 먼 거리에서 좁은 길(64비트 안팎)로 데이터를 주고받습니다. HBM은 발상을 바꿨습니다. D램 칩을 얇게 갈아 여러 층으로 쌓고, 칩을 위아래로 뚫는 수천 개의 미세한 구멍에 구리를 채워 층끼리 연결합니다. 이 수직 통로를 TSV(실리콘 관통전극)라고 합니다. 아파트에 엘리베이터 수천 대를 설치한 셈입니다.
이렇게 쌓은 HBM을 GPU 바로 옆(수 밀리미터 거리)에 붙이면 1,024~2,048개의 데이터 통로를 한꺼번에 쓸 수 있습니다. 2차선 도로 대신 2,000차선 고속도로를 깐 것과 같습니다. 대신 칩을 종잇장처럼 얇게 갈고, 층마다 정확히 맞춰 붙이고, 열을 빼는 기술이 필요해 만들기가 매우 어렵습니다. SK하이닉스는 접착 소재를 녹여 채우는 MR-MUF 방식, 삼성전자는 필름을 끼워 눌러 붙이는 TC-NCF 방식을 주로 써 왔고, 다음 세대로는 범프 없이 구리끼리 직접 붙이는 하이브리드 본딩이 거론됩니다.
HBM4는 무엇이 달라졌나
| 항목 | HBM3(이전) | HBM4(JEDEC 표준) |
|---|---|---|
| 데이터 통로(인터페이스) | 1,024비트 | 2,048비트(두 배) |
| 독립 채널 | 16개 | 32개 |
| 스택당 대역폭 | — | 최대 2TB/s(HBM3의 두 배) |
| 쌓는 층수 | 최대 12단 수준 | 4·8·12·16단 |
| 스택당 최대 용량 | 32GB 수준 | 64GB(32Gb 칩 16단) |
자료: JEDEC JESD270-4 HBM4 표준(2025.4), All About Circuits 정리
HBM4의 또 다른 변화는 맨 아래층인 베이스 다이입니다. 예전에는 메모리 회사가 자체 공정으로 만들었지만, HBM4부터는 이 층에 더 복잡한 로직 회로가 들어가면서 파운드리 공정을 쓰기 시작했습니다. SK하이닉스 HBM4의 베이스 다이는 TSMC 12나노 공정으로 만든다고 보도되었습니다. 메모리 회사와 파운드리가 한 제품 안에서 협업하는, 공급망의 새 연결고리입니다.
엔비디아 루빈 GPU 한 개에는 HBM4 스택 8개가 붙어 총 288GB, 초당 22TB의 대역폭을 냅니다. 스택 하나에 36GB인 셈으로, 24Gb(3GB) 칩을 12단으로 쌓은 구성과 맞아떨어집니다.
낸드와 키옥시아: 창고도 층을 쌓는다
낸드플래시 역시 ‘쌓기’ 경쟁을 합니다. 다만 HBM처럼 완성된 칩을 쌓는 것이 아니라, 한 칩 안에서 저장 셀을 수백 층으로 세워 올리는 3D 낸드 방식입니다. 단층 창고를 고층 물류센터로 바꾼 셈입니다.
일본의 키옥시아(옛 도시바 메모리)는 미국 샌디스크와 함께 요카이치·기타카미 공장을 운영합니다. 차세대 BiCS 10은 332단으로, 이전 218단 세대보다 면적당 저장 밀도가 59% 높고 데이터 전송 속도는 33% 빠릅니다. 키옥시아는 층수 경쟁만 하기보다 회로 웨이퍼와 셀 웨이퍼를 따로 만들어 붙이는 CBA 방식으로 속도를 높이는 전략을 씁니다.
| 키옥시아 지표 | 내용 |
|---|---|
| 차세대 제품 | BiCS 10, 332단(이전 218단). 2026년 여름 샘플, 2027년 양산 목표(보도) |
| 설비투자 계획 | 2026~2028회계연도 연평균 약 4,700억 엔(2025년보다 약 66%↑) |
| 수요 전망(회사) | 낸드 비트 수요 연평균 22% 성장, 그중 AI 추론용은 연 86% 성장 |
| 목표 | 2028년까지 매출의 60% 이상을 데이터센터·기업용 저장장치에서 |
자료: TrendForce(2026.6.3). 수요 전망은 회사 자체 추정
AI가 학습 단계에서 추론(실제 서비스) 단계로 넘어가면서, 대화 기록과 문서를 빠르게 꺼내 쓰는 고용량 SSD 수요가 늘고 있습니다. 메모리 업계에서 ‘HBM은 D램, SSD는 낸드의 AI 수혜’라고 나눠 부르는 이유입니다.
HBM4 공급 경쟁: 점유율과 실적
2026년 메모리 시장의 핵심 뉴스는 HBM4 공급 경쟁입니다. 2026년 6월 5일 엔비디아는 삼성전자·SK하이닉스·마이크론 세 회사가 모두 루빈용 HBM4 인증을 통과했다고 확인했습니다. 다만 회사별 물량 배분은 공개하지 않았습니다.
| 지표 | 숫자 | 출처·기준 |
|---|---|---|
| 전체 D램 점유율 | 삼성 39%, SK하이닉스 26%, 마이크론 25% | Counterpoint, 2026년 2분기 |
| 루빈용 HBM4 물량 추정 | SK하이닉스 약 60~70%, 삼성 약 25~30%, 나머지 마이크론 | 분석가 추정(공식 아님) |
| 삼성전자 잠정 실적 | 매출 195조 원(▲126.6%), 영업이익 107.4조 원 | 2026년 3분기 잠정 |
| SK하이닉스 D램 매출 증가율 | 전년 대비 ▲214% | Counterpoint, 2026년 2분기 |
| CXMT(중국) D램 매출 증가율 | 전년 대비 ▲716% | Counterpoint, 2026년 2분기 |
자료: Counterpoint Research, Yahoo Finance(2026.6.5), Korea Times(2026.10.8), TechNews(2026.7.15)
흥미로운 점은 SK하이닉스 매출이 세 배 넘게 늘었는데도 전체 D램 점유율 1위는 삼성전자에게 돌아갔다는 것입니다. HBM에서는 SK하이닉스가 앞서 있지만, 일반 D램 가격이 크게 오르면서 생산량이 많은 삼성전자가 더 큰 혜택을 받았습니다. 삼성전자의 3분기 잠정 영업이익 107.4조 원은 한국 기업 최초의 분기 100조 원 돌파입니다.
중국 CXMT의 빠른 성장도 눈여겨볼 대목입니다. 새로운 D램 구조를 앞세운 창신메모리의 4F2 발표가 메모리 업계 승자·패자 구도에 준 충격은 HBM 호황 속에서도 일반 D램 경쟁이 치열해질 수 있음을 보여 줍니다.
누가 관련되나, 그리고 앞으로
HBM 한 제품에도 여러 회사가 얽혀 있습니다. 메모리 3사 외에, HBM을 쌓아 붙이는 열압착 본딩 장비(한미반도체·한화세미텍 등), 웨이퍼를 얇게 갈고 자르는 장비(일본 디스코), 베이스 다이를 만드는 파운드리(TSMC), 완성된 HBM을 검사하는 테스트 장비(어드반테스트) 회사가 연결됩니다. 이 회사들이 오르거나 내린다는 뜻이 아니라, HBM 수요의 파도가 이 경로를 따라 전달된다는 뜻입니다.
- ▸ 기본: 2026년 4분기 HBM4가 HBM3E를 넘어 주력이 되고, 2027년 루빈 울트라(GPU당 HBM4E 1TB) 준비로 수요 유지. 확인 신호는 메모리 3사 분기 실적의 HBM 비중.
- ▸ 낙관: 고객 맞춤형 HBM(베이스 다이에 고객 로직 탑재)이 늘어 메모리 회사의 가격 협상력이 강해짐. 확인 신호는 장기공급계약(LTA) 비중 확대.
- ▸ 비관: 3사 증설과 중국 업체 추격으로 2027~2028년 공급 과잉, 가격 하락. 확인 신호는 D램 고정거래가격 상승률 둔화.
반대 의견과 주의할 점
메모리는 역사적으로 호황과 불황이 반복된 산업입니다. 가격이 오르면 모든 회사가 증설하고, 1~2년 뒤 공급이 넘치면 가격이 급락하는 일이 여러 번 있었습니다. 장기공급계약 비중이 늘어 이번에는 다르다는 주장도 있지만 아직 검증되지 않았습니다. 또 HBM 점유율은 조사 기관마다 크게 다르게 나오고, 루빈용 물량 배분은 엔비디아가 공개하지 않은 추정치라는 점을 기억해야 합니다.
🗒️ 한 장 요약
| 개념 | 한 줄 정리 |
|---|---|
| HBM4 | D램을 12~16단 쌓아 GPU 옆에 붙인 6세대 고대역폭 메모리, 2,048비트·스택당 최대 2TB/s |
| 메모리 벽 | GPU 계산 속도를 메모리 데이터 공급이 못 따라가는 현상 |
| TSV | 쌓은 칩을 수직으로 잇는 구리 통로(엘리베이터) |
| 베이스 다이 | HBM 맨 아래 로직 층. HBM4부터 파운드리 공정 사용 |
| 3D 낸드 | 한 칩 안에서 저장 셀을 수백 층 세움. 키옥시아 BiCS 10은 332단 |
| 점유율 | D램 전체는 삼성 1위(39%), 루빈용 HBM4는 SK하이닉스 우위(추정) |
함께 알면 좋은 용어
- 대역폭 — 1초에 주고받을 수 있는 데이터 양. 도로 차선 수 × 차 속도로 생각하면 쉽다.
- 휘발성 — 전원이 꺼지면 저장 내용이 사라지는 성질. D램은 휘발성, 낸드는 비휘발성이다.
- 장기공급계약(LTA) — 고객과 몇 년 치 물량·가격을 미리 정하는 계약. 가격 변동 충격을 줄인다.
자주 묻는 질문
Q1. HBM4란 무엇인가요?
D램 칩을 여러 층 쌓고 TSV로 연결해 GPU 바로 옆에 붙이는 6세대 고대역폭 메모리입니다. 데이터 통로가 2,048비트로 HBM3의 두 배이며 스택당 최대 2TB/s를 냅니다.
Q2. HBM과 일반 D램은 어떻게 다른가요?
일반 D램은 메인보드 슬롯에 꽂혀 좁은 통로로 데이터를 주고받고, HBM은 칩을 쌓아 GPU와 한 패키지 안에 붙여 수천 개의 통로로 데이터를 보냅니다. 속도는 훨씬 빠르지만 만들기 어렵고 비쌉니다.
Q3. 키옥시아는 어떤 회사인가요?
옛 도시바의 메모리 사업이 분리된 일본 낸드플래시 회사입니다. 샌디스크와 함께 일본 요카이치·기타카미 공장을 운영하며, 332단 BiCS 10을 준비하고 있습니다.
함께 읽으면 좋은 글
- 스페이스X 실적으로 본 AI 연산 돈의 흐름 — AI 연산 수요가 어디서 돈이 되는지
- 일본 증시 전망과 반도체·금리 시나리오 — 키옥시아·디스코가 속한 일본 반도체 시장의 큰 그림
📚 시리즈 「반도체 A to Z」 전 5편
공정 순서부터 AI 데이터센터 랙까지
참고 자료
- All About Circuits: JEDEC HBM4 표준 발표
- Counterpoint Research: 분기별 D램·HBM 점유율
- Yahoo Finance: 엔비디아, 메모리 3사 HBM4 인증
- TrendForce: 키옥시아 설비투자 계획과 BiCS 10
- TechNews: SK하이닉스 12단 HBM4 양산
- Korea Times: 삼성전자 3분기 잠정실적
2026년 10월 22일 기준 공개 자료를 바탕으로 정리했습니다. 보도·추정치는 본문에 따로 표시했습니다. 정보 제공용이며 투자 권유가 아닙니다.